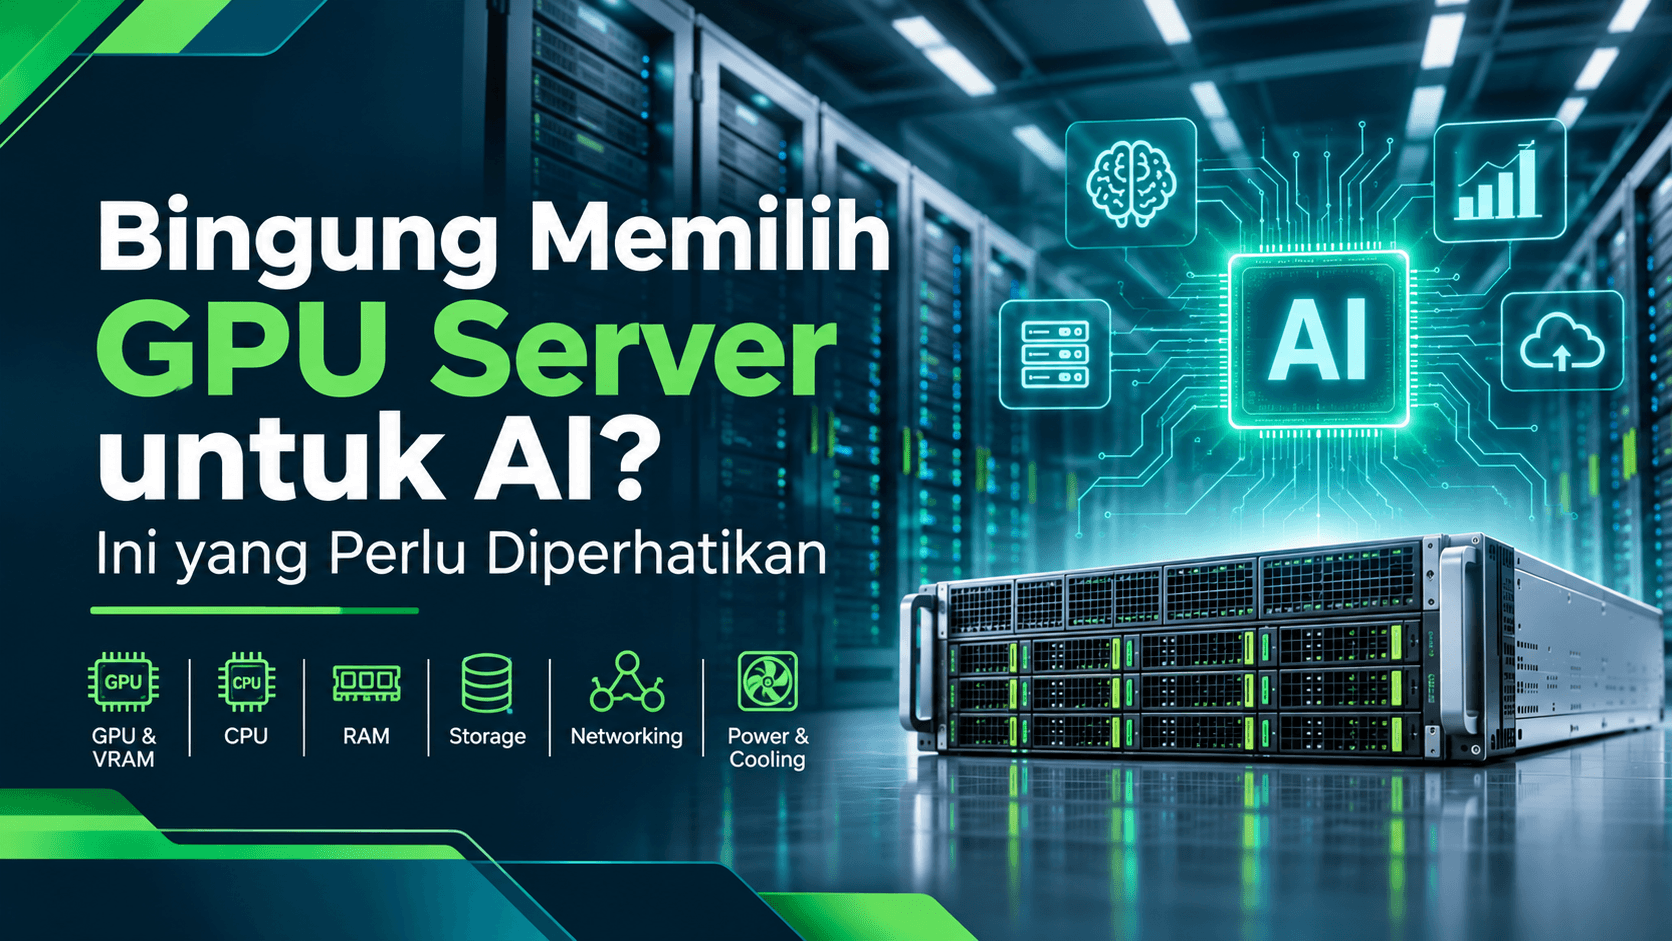
Bingung Memilih GPU Server untuk AI? Jangan Sampai Salah Spesifikasi dan Boros Anggaran
Perusahaan mulai tertarik menggunakan Artificial Intelligence (AI) untuk membantu pekerjaan sehari-hari. Ada yang ingin membangun chatbot internal, mengotomatisasi analisis dokumen, mengembangkan sistem pengenalan gambar, hingga menjalankan model AI sendiri agar pengelolaan data lebih terkontrol.
Namun, ketika mulai mencari perangkat pendukungnya, muncul satu masalah yang cukup sering terjadi: bingung memilih GPU server yang benar-benar sesuai dengan kebutuhan AI perusahaan.
Pilihan perangkat di pasaran sangat beragam. Ada GPU NVIDIA dengan kapasitas VRAM berbeda, server dengan konfigurasi satu hingga beberapa GPU, serta pilihan CPU, RAM, storage, dan sistem pendinginan yang tidak kalah penting.
Tidak sedikit perusahaan yang akhirnya berfokus pada GPU dengan spesifikasi paling tinggi karena dianggap paling aman untuk kebutuhan jangka panjang. Padahal, membeli GPU server dengan harga mahal belum tentu membuat workload AI berjalan lebih optimal.
Kesalahan dalam menentukan spesifikasi bisa membuat investasi membengkak, kapasitas perangkat tidak terpakai maksimal, atau justru server tidak mampu menjalankan model AI yang dibutuhkan.
Lalu, bagaimana cara menentukan GPU server yang tepat tanpa mengeluarkan anggaran berlebihan?
Mengapa Memilih GPU Server untuk AI Tidak Bisa Asal Mahal?
Bayangkan sebuah perusahaan ingin menggunakan chatbot AI untuk membantu karyawan mencari informasi dari dokumen internal. Tim IT kemudian mulai mencari server dengan GPU berperforma tinggi.
Setelah membandingkan beberapa pilihan, perusahaan menemukan server dengan beberapa GPU dan kapasitas VRAM besar. Konfigurasinya terlihat menjanjikan, tetapi ternyata kebutuhan penggunaan chatbot internal tersebut belum tentu memerlukan infrastruktur sebesar itu.
Situasinya bisa berbeda apabila perusahaan ingin melatih model AI sendiri menggunakan dataset berukuran besar atau menyediakan layanan AI untuk ribuan pengguna secara bersamaan.
Inilah alasan mengapa pemilihan GPU server untuk AI harus dimulai dari kebutuhan workload, bukan sekadar melihat spesifikasi tertinggi.
Beberapa hal yang perlu dipahami sebelum membeli meliputi:
- Jenis aplikasi AI yang akan dijalankan.
- Ukuran model dan kebutuhan VRAM.
- Target performa training atau inference.
- Jumlah pengguna dan permintaan secara bersamaan.
- Kebutuhan CPU, RAM, storage, dan networking.
- Konsumsi daya serta sistem pendinginan.
- Kompatibilitas software dan rencana ekspansi.
Jika faktor-faktor tersebut tidak diperhitungkan, perusahaan berisiko membeli infrastruktur yang terlalu besar atau justru kurang mampu memenuhi kebutuhan operasional.
Apa Itu GPU Server dan Mengapa Dibutuhkan untuk AI?
GPU server adalah sistem server yang dilengkapi satu atau beberapa Graphics Processing Unit (GPU) untuk mempercepat pekerjaan komputasi tertentu.
Berbeda dengan CPU yang dirancang untuk menangani berbagai instruksi secara fleksibel, GPU memiliki banyak unit pemrosesan yang memungkinkan operasi tertentu dilakukan secara paralel.
Kemampuan tersebut sangat berguna untuk workload AI, terutama yang melibatkan perhitungan matriks dan tensor dalam jumlah besar.
Dalam implementasi AI perusahaan, GPU server umumnya digunakan untuk dua kebutuhan utama.
AI Training: Ketika Perusahaan Ingin Melatih Model Sendiri
Training merupakan proses melatih model AI menggunakan data agar sistem dapat mempelajari pola dan menghasilkan prediksi atau output tertentu.
Proses ini dapat membutuhkan kemampuan komputasi besar, terutama ketika model memiliki banyak parameter atau dataset yang digunakan berukuran besar.
Contoh penggunaannya antara lain:
- Melatih model Deep Learning.
- Mengembangkan model Computer Vision.
- Melakukan Fine-Tuning Large Language Model (LLM).
- Mengembangkan aplikasi Generative AI.
- Menjalankan eksperimen Machine Learning dalam skala besar.
Pada workload tersebut, kemampuan komputasi GPU dan kapasitas memory menjadi faktor penting. Namun, waktu training juga dipengaruhi oleh ukuran dataset, arsitektur model, algoritma, optimasi software, dan konfigurasi sistem secara keseluruhan.
AI Inference: Ketika Model Digunakan untuk Kebutuhan Operasional
Berbeda dengan training, inference merupakan proses menggunakan model AI yang sudah dilatih untuk menghasilkan respons berdasarkan input baru.
Contohnya terjadi ketika karyawan mengirim pertanyaan ke chatbot perusahaan. Sistem akan memproses pertanyaan tersebut menggunakan model AI, kemudian menghasilkan jawaban.
Inference juga digunakan untuk:
- Virtual Assistant.
- Analisis Dokumen.
- Pengenalan Gambar.
- Sistem Rekomendasi.
- Pemrosesan Bahasa Alami.
- Analisis Video Otomatis.
- Aplikasi Generative AI.
Kebutuhan GPU untuk inference dipengaruhi oleh ukuran model, jumlah pengguna, panjang input dan output, serta target waktu respons.
Karena karakteristiknya berbeda, server yang dirancang untuk training belum tentu menjadi konfigurasi paling efisien untuk inference.
VRAM GPU: Mengapa Model AI Bisa Gagal Dijalankan Meski GPU Sudah Mahal?
Salah satu kesalahan dalam memilih perangkat AI adalah hanya memperhatikan performa GPU tanpa menghitung kapasitas VRAM.
VRAM atau Video Random Access Memory merupakan memory pada GPU yang digunakan untuk menyimpan data selama proses komputasi.
Dalam workload AI, VRAM dapat digunakan untuk menyimpan:
- Bobot atau parameter model AI.
- Aktivasi selama proses training.
- Data input dan output.
- Tensor dan buffer komputasi.
- Cache selama proses inference.
Bayangkan perusahaan ingin menjalankan Large Language Model untuk chatbot internal. Sebelum dapat digunakan, model harus dimuat ke memory GPU.
Namun, kebutuhan memory tidak hanya berasal dari ukuran model. Sistem juga membutuhkan ruang tambahan untuk cache, aktivasi, dan proses komputasi lainnya.
Jika kebutuhan memory melebihi kapasitas VRAM yang tersedia, model mungkin tidak dapat dijalankan dengan konfigurasi tersebut tanpa menggunakan teknik optimasi atau pembagian workload.
Apakah VRAM Lebih Besar Selalu Lebih Baik?
Tidak selalu.
GPU dengan VRAM besar memang dapat menampung model dan data dalam kapasitas lebih besar. Namun, kapasitas tersebut bukan satu-satunya faktor yang menentukan performa.
Perusahaan juga perlu memperhatikan:
- Memory Bandwidth.
- Kemampuan komputasi GPU.
- Arsitektur GPU.
- Dukungan software.
- Jumlah pengguna secara bersamaan.
- Kebutuhan batch size dan panjang konteks model.
Sebagai contoh, GPU dengan kapasitas VRAM lebih besar belum tentu memberikan waktu pemrosesan lebih cepat apabila kemampuan komputasi atau bandwidth memory-nya kurang sesuai untuk workload tertentu.
Sebaliknya, GPU dengan kemampuan komputasi tinggi juga belum tentu dapat menjalankan model yang dibutuhkan jika kapasitas VRAM tidak mencukupi.
Karena itu, kapasitas memory dan kemampuan komputasi GPU harus dievaluasi secara bersamaan.
Apa yang Bisa Dilakukan Jika VRAM Tidak Mencukupi?
Ada beberapa pendekatan untuk mengurangi kebutuhan memory model AI, tergantung dukungan software dan karakteristik workload.
Salah satunya adalah Quantization, yaitu teknik untuk mengurangi presisi representasi numerik model sehingga kebutuhan memory dapat ditekan.
Pendekatan lain meliputi pengurangan batch size, optimasi model, atau penggunaan beberapa GPU apabila software dan arsitektur sistem mendukungnya.
Setiap pendekatan memiliki konsekuensi terhadap performa, kompleksitas konfigurasi, maupun kualitas output yang dihasilkan.
Memilih GPU NVIDIA: GeForce, RTX Professional, atau Data Center GPU?
Setelah memahami workload dan kebutuhan VRAM, langkah berikutnya adalah menentukan jenis GPU yang sesuai.
NVIDIA memiliki beberapa keluarga GPU dengan karakteristik dan target penggunaan berbeda. Perusahaan perlu memahami perbedaannya sebelum menentukan perangkat untuk infrastruktur AI.
NVIDIA GeForce
GeForce umumnya ditujukan untuk gaming dan penggunaan konsumen. Beberapa modelnya juga digunakan untuk eksperimen Machine Learning dan pengembangan AI.
GPU ini dapat dipertimbangkan untuk lingkungan pengembangan tertentu dengan memperhatikan kapasitas VRAM, kompatibilitas server, batas daya, dukungan software, dan ketentuan penggunaan produk.
Namun, GPU konsumen tidak otomatis memiliki seluruh fitur, dukungan, maupun karakteristik operasional yang tersedia pada GPU Data Center.
NVIDIA RTX Professional
GPU NVIDIA RTX untuk workstation profesional dapat digunakan untuk berbagai kebutuhan komputasi visual, pengembangan AI, simulasi, dan aplikasi profesional yang kompatibel.
Pemilihannya perlu disesuaikan dengan kebutuhan software, kapasitas memory, performa, serta bentuk perangkat yang akan digunakan.
NVIDIA Data Center GPU
Untuk kebutuhan komputasi di lingkungan server dan Data Center, NVIDIA menyediakan keluarga GPU Data Center.
Beberapa model yang dikenal dalam kategori ini antara lain NVIDIA A100, H100, dan H200.
Setiap model memiliki karakteristik berbeda, mulai dari kapasitas memory, bandwidth, kemampuan komputasi, konsumsi daya, hingga dukungan platform.
Tidak semua GPU Data Center cocok untuk setiap workload. Perusahaan perlu membandingkan spesifikasi aktual dan memastikan kompatibilitasnya dengan server serta software yang digunakan.
Selain model GPU, konfigurasi aktual dari vendor server juga harus diperiksa. Dukungan GPU, sistem pendinginan, jumlah slot, power delivery, dan opsi networking dapat berbeda pada setiap platform.
Jangan Hanya Fokus pada GPU, CPU dan RAM Juga Menentukan Performa
GPU memang menjadi komponen utama dalam banyak konfigurasi AI. Namun, CPU dan RAM tetap memiliki peran penting untuk memastikan keseluruhan sistem bekerja dengan optimal.
CPU bertanggung jawab menjalankan sistem operasi, mengelola proses, menyiapkan data, serta menangani berbagai tugas yang tidak sepenuhnya dikerjakan oleh GPU.
Sementara itu, RAM digunakan untuk menyimpan data dan proses yang sedang digunakan sistem sebelum atau selama data tersebut diproses.
Jika CPU atau RAM tidak mencukupi, GPU dapat menunggu data yang diperlukan sehingga pemanfaatannya menjadi kurang optimal.
CPU untuk Mendukung Workload AI
Kebutuhan CPU bergantung pada jenis workload yang dijalankan.
Server untuk inference dengan pipeline sederhana dapat memiliki kebutuhan berbeda dibandingkan server yang melakukan preprocessing dataset, menjalankan beberapa layanan, atau mengoordinasikan training terdistribusi.
Beberapa aspek yang perlu diperhatikan adalah jumlah core dan thread, jumlah jalur PCIe, kompatibilitas platform, serta dukungan terhadap konfigurasi GPU yang dipilih.
RAM untuk Pengolahan Dataset
RAM berperan dalam proses preprocessing, pemuatan dataset, caching, dan pengelolaan beberapa proses secara bersamaan.
Jika dataset berukuran besar atau server menjalankan beberapa workload sekaligus, kebutuhan RAM dapat meningkat.
Karena itu, kapasitas RAM perlu ditentukan berdasarkan kebutuhan aplikasi dan pola penggunaan data, bukan hanya berdasarkan kapasitas VRAM GPU.
Storage dan Networking: Bottleneck yang Sering Terlupakan
GPU dengan spesifikasi tinggi tidak akan bekerja optimal apabila data yang dibutuhkan terlambat tersedia.
Inilah alasan mengapa storage dan networking juga perlu diperhatikan ketika perusahaan merancang infrastruktur AI.
Storage untuk Dataset dan Model AI
Dataset AI dapat terdiri dari jutaan gambar, file video, dokumen, maupun data numerik.
Media penyimpanan harus mampu menyediakan data dengan kecepatan yang sesuai agar GPU tidak terlalu sering menunggu proses pembacaan data.
SSD dapat dipertimbangkan untuk menyimpan dataset aktif, cache, dan workload yang sensitif terhadap latensi. Sementara itu, storage berkapasitas besar dapat digunakan untuk menyimpan dataset historis, arsip, serta hasil eksperimen.
Beberapa aspek yang perlu diperhatikan meliputi kapasitas penyimpanan, throughput, IOPS, latensi, ketahanan media, redundansi, dan mekanisme backup.
Networking untuk Infrastruktur AI Multi-GPU
Pada sistem AI yang menggunakan beberapa GPU atau beberapa server, networking menjadi salah satu komponen penting.
Training terdistribusi membutuhkan komunikasi antarkomponen untuk melakukan sinkronisasi parameter, pertukaran data, maupun operasi kolektif lainnya.
Ketika komunikasi antarsistem menjadi bottleneck, penambahan GPU belum tentu memberikan peningkatan performa secara proporsional.
Karena itu, infrastruktur AI skala besar dapat membutuhkan jaringan berkecepatan tinggi dan teknologi komunikasi antarnode yang sesuai dengan ukuran workload serta arsitektur sistem.
Berapa Banyak GPU yang Dibutuhkan untuk Menjalankan AI?
Tidak ada jumlah GPU yang berlaku untuk semua perusahaan.
Satu GPU mungkin sudah cukup untuk menjalankan model tertentu. Namun, workload lain dapat membutuhkan beberapa GPU untuk memenuhi kebutuhan memory atau mempercepat proses pemrosesan.
Sebelum menentukan jumlahnya, perusahaan perlu mengevaluasi:
- Ukuran model dan kebutuhan VRAM.
- Target waktu training atau inference.
- Jumlah pengguna yang mengakses sistem secara bersamaan.
- Volume permintaan per detik.
- Ukuran dataset.
- Panjang konteks model.
- Kebutuhan batch processing.
- Kemampuan software memanfaatkan beberapa GPU.
- Anggaran pengadaan dan operasional.
Sebagai contoh, perusahaan yang ingin menjalankan chatbot internal untuk puluhan pengguna belum tentu membutuhkan konfigurasi yang sama dengan perusahaan yang menyediakan layanan AI untuk ribuan pengguna secara bersamaan.
Kebutuhan tersebut sebaiknya dihitung melalui pengujian model, estimasi workload, dan benchmark yang relevan.
Perlu diingat bahwa penambahan GPU juga tidak selalu menghasilkan peningkatan performa secara linear. Hasilnya dipengaruhi oleh overhead komunikasi, bandwidth, kapasitas memory, dan kemampuan aplikasi dalam mendistribusikan pekerjaan.
Server AI Membutuhkan Power Supply dan Cooling yang Tepat
Ada satu hal yang sering baru diperhatikan setelah perusahaan menentukan konfigurasi GPU: kebutuhan listrik dan pendinginan.
GPU server untuk AI dapat mengonsumsi daya besar, terutama ketika menggunakan beberapa GPU berperforma tinggi. Konsumsi daya juga berasal dari CPU, memory, storage, kipas, dan komponen lainnya.
Karena itu, perusahaan perlu memastikan konfigurasi server didukung oleh sistem kelistrikan dan pendinginan yang memadai.
Beberapa hal yang perlu dievaluasi meliputi:
- Kebutuhan daya total server.
- Kapasitas dan redundansi power supply.
- Ketersediaan jalur listrik yang sesuai.
- Sistem pendinginan dan aliran udara.
- Batas temperatur operasional.
- Kapasitas pendinginan ruang server.
- Kebutuhan rack dan distribusi daya.
Pada konfigurasi GPU dengan densitas tinggi, pendinginan udara mungkin perlu dievaluasi bersama opsi pendinginan cair yang didukung oleh platform.
Pemilihan sistem pendinginan harus mengikuti spesifikasi perangkat dan desain Data Center. Server dengan GPU berdaya tinggi membutuhkan perencanaan berbeda dibandingkan server kantor biasa.
Perencanaan daya dan pendinginan sejak awal membantu perusahaan mengurangi risiko thermal throttling, gangguan operasional, serta keterbatasan ekspansi infrastruktur.
Untuk memahami lebih lanjut mengenai kesiapan fasilitas pendukung workload AI, perusahaan juga dapat membaca artikel AI-Ready Data Center: Menyiapkan Power & Cooling Infrastructure untuk Workload AI Bersama Vertiv.
Cara Memilih GPU Server yang Sesuai dengan Kebutuhan Perusahaan
Daripada langsung memilih GPU paling mahal, perusahaan sebaiknya memulai dari kebutuhan aplikasi dan workload yang akan dijalankan.
Berikut langkah yang dapat digunakan sebagai panduan sebelum melakukan pengadaan.
1. Tentukan Tujuan Penggunaan AI
Identifikasi apakah server akan digunakan untuk training model, fine-tuning, menjalankan LLM untuk chatbot internal, inference aplikasi bisnis, Computer Vision, Generative AI, atau eksperimen Machine Learning.
Tujuan penggunaan akan membantu menentukan kebutuhan komputasi, kapasitas memory, dan konfigurasi server.
2. Perkirakan Kebutuhan VRAM
Periksa kebutuhan memory model, termasuk bobot model, aktivasi, cache, dan buffer komputasi.
Untuk LLM, kebutuhan VRAM juga dipengaruhi oleh panjang konteks, jumlah pengguna bersamaan, Quantization, dan implementasi inference.
Jangan menggunakan ukuran file model saja sebagai satu-satunya dasar penentuan VRAM karena kebutuhan runtime biasanya mencakup komponen tambahan.
3. Pilih GPU Berdasarkan Workload
Bandingkan kapasitas VRAM, bandwidth memory, kemampuan komputasi, dukungan software, konsumsi daya, dan harga.
Untuk training, perhatikan juga kemampuan komunikasi antar-GPU apabila sistem menggunakan beberapa GPU.
Sementara itu, untuk inference, throughput, latensi, jumlah permintaan bersamaan, dan efisiensi operasional menjadi aspek penting.
4. Sesuaikan CPU dan RAM
Pastikan CPU mampu mendukung workload dan GPU yang dipilih.
Kapasitas RAM juga harus mencukupi untuk pemrosesan data, caching, serta aplikasi pendukung. Selain itu, kompatibilitas motherboard, PCIe, dan konfigurasi memory perlu diperiksa sebelum pengadaan.
5. Evaluasi Storage dan Networking
Tentukan bagaimana dataset dan model akan disimpan serta dipindahkan ke GPU server.
Jika workload membutuhkan pembacaan data berkecepatan tinggi atau melibatkan beberapa server, storage dan networking perlu dirancang agar tidak menjadi bottleneck.
6. Hitung Total Biaya Infrastruktur
Harga GPU server bukan satu-satunya biaya yang harus dipertimbangkan.
Perusahaan perlu menghitung Total Cost of Ownership (TCO), termasuk:
- Harga server dan GPU.
- Konsumsi listrik.
- Sistem pendinginan.
- Lisensi software jika diperlukan.
- Pemeliharaan dan garansi.
- Biaya jaringan dan storage.
- Dukungan teknis.
- Pengembangan kapasitas di masa depan.
Dengan mempertimbangkan TCO, perusahaan dapat membandingkan biaya investasi dengan performa yang benar-benar dibutuhkan.
Contoh Kebutuhan GPU Server untuk Dua Jenis Perusahaan
Untuk memahami bagaimana kebutuhan workload memengaruhi konfigurasi, bayangkan dua perusahaan yang ingin menggunakan AI untuk mendukung operasional.
Perusahaan pertama ingin mengembangkan chatbot internal menggunakan model AI yang sudah tersedia. Penggunaannya masih terbatas pada karyawan dan volume permintaannya relatif terkendali.
Perusahaan kedua ingin melatih model AI berukuran besar, memproses dataset dalam skala tinggi, serta menyediakan layanan inference untuk banyak pengguna.
Kedua perusahaan tersebut belum tentu membutuhkan konfigurasi GPU server yang sama.
Untuk perusahaan pertama, satu GPU dengan kapasitas VRAM memadai mungkin sudah dapat memenuhi kebutuhan, selama ukuran model, target latensi, dan jumlah pengguna masih dapat dilayani oleh konfigurasi tersebut.
Sementara itu, perusahaan kedua mungkin membutuhkan beberapa GPU, jaringan berkecepatan tinggi, storage berperforma tinggi, serta desain daya dan pendinginan yang lebih kompleks.
Contoh ini menunjukkan bahwa perencanaan infrastruktur AI perlu mengikuti kebutuhan workload aktual, bukan sekadar spesifikasi perangkat.
Secara sederhana, proses perencanaannya dapat mengikuti alur berikut:
Workload AI → Ukuran Model → Kebutuhan VRAM → GPU → CPU dan RAM → Storage → Networking → Power dan Cooling → Skalabilitas
Kapan Perusahaan Perlu Menggunakan GPU Server?
GPU server layak dipertimbangkan ketika workload membutuhkan akselerasi komputasi yang sesuai dengan kemampuan GPU.
Beberapa kondisi yang dapat menjadi pertimbangan antara lain:
- Perusahaan mengembangkan model Deep Learning.
- Training model membutuhkan waktu terlalu lama pada infrastruktur yang tersedia.
- Aplikasi AI membutuhkan inference dengan throughput tinggi.
- Model tidak dapat dijalankan secara efisien pada konfigurasi CPU yang tersedia.
- Perusahaan ingin menjalankan beberapa workload AI secara terpusat.
- Kebutuhan komputasi AI meningkat secara konsisten.
Namun, tidak semua aplikasi AI membutuhkan GPU server khusus.
Sebagian workload Machine Learning yang lebih sederhana dapat berjalan dengan baik menggunakan CPU. Untuk kebutuhan eksperimen tertentu, perusahaan juga dapat memanfaatkan workstation atau layanan cloud sesuai kebutuhan.
Keputusan penggunaan GPU server sebaiknya didasarkan pada pengujian performa, biaya, skala penggunaan, serta kebutuhan pengelolaan infrastruktur.
Solusi GPU Server dan AI Infrastructure Bersama Multipro.id
Memilih GPU server bukan hanya tentang menentukan model GPU atau kapasitas VRAM. Perusahaan juga perlu memastikan server, storage, networking, power, dan cooling dapat bekerja sebagai satu infrastruktur yang saling mendukung.
Multipro.id membantu perusahaan mengevaluasi kebutuhan infrastruktur IT dan AI berdasarkan workload, kapasitas, serta rencana pengembangan bisnis.
Untuk kebutuhan tersebut, perusahaan dapat mempertimbangkan solusi server enterprise, GPU server, storage, networking, hingga Data Center Infrastructure yang disesuaikan dengan kebutuhan operasional.
Jika perusahaan masih belum yakin mengenai spesifikasi yang dibutuhkan, konsultasi sebelum pembelian dapat membantu mengidentifikasi konfigurasi yang lebih sesuai, sehingga investasi tidak hanya berfokus pada spesifikasi tertinggi, tetapi juga pada kebutuhan aktual.
Tentang Multipro.id
Multipro.id adalah Pusat Solusi Infrastruktur IT di Indonesia dengan pengalaman lebih dari 25 tahun. Mitra Resmi dari berbagai brand IT ternama seperti APC, Dell, Lenovo, HPE, Asus, Vertiv, Bitdefender, Palo Alto, Fortinet, Cisco, Synology, Ruijie, Microsoft dan lainnya.
Dalam mendukung kebutuhan infrastruktur AI dan server perusahaan, Multipro.id menyediakan beberapa keunggulan:
- Produk original & bergaransi resmi.
- Harga termasuk PPN + e-Faktur.
- Konsultasi sebelum pembelian.
- Dukungan untuk kebutuhan kantor & perusahaan.
Untuk mendiskusikan kebutuhan GPU server, AI Infrastructure, atau pengadaan server perusahaan, Anda dapat menghubungi tim Multipro.id melalui halaman konsultasi resmi.
Kesimpulan: GPU Server Terbaik Adalah yang Sesuai dengan Workload
Memilih GPU server untuk AI membutuhkan pertimbangan yang lebih luas daripada sekadar memilih GPU dengan spesifikasi tertinggi.
Perusahaan perlu memahami tujuan penggunaan AI, karakteristik model, kapasitas VRAM, kemampuan komputasi GPU, CPU, RAM, storage, networking, serta kebutuhan daya dan pendinginan.
Untuk workload tertentu, satu GPU dengan kapasitas memory memadai mungkin sudah dapat memenuhi kebutuhan. Sementara itu, training model berskala besar atau layanan inference dengan volume tinggi dapat memerlukan konfigurasi multi-GPU dan infrastruktur yang lebih kompleks.
Pemilihan GPU juga perlu mempertimbangkan kompatibilitas software, performa aktual, anggaran operasional, dan rencana ekspansi.
Pada akhirnya, GPU server terbaik bukan selalu perangkat dengan jumlah GPU terbanyak atau kapasitas VRAM terbesar, melainkan sistem yang mampu menjalankan workload AI secara efektif, efisien, dan dapat dikembangkan sesuai kebutuhan perusahaan.
FAQ: Pertanyaan Umum tentang GPU Server untuk AI
Apa itu GPU server untuk AI?
GPU server untuk AI adalah server yang menggunakan satu atau beberapa GPU untuk mempercepat workload seperti training model, inference, Deep Learning, Computer Vision, dan Generative AI.
Apa perbedaan GPU server dan CPU server?
CPU server mengandalkan CPU untuk menjalankan berbagai instruksi dan layanan. Sementara itu, GPU server dilengkapi GPU yang dapat mempercepat operasi komputasi paralel tertentu. Keduanya juga dapat digunakan bersama dalam satu sistem.
Apa itu VRAM pada GPU server?
VRAM adalah memory pada GPU yang digunakan untuk menyimpan data dan informasi yang diperlukan selama proses pemrosesan. Dalam AI, VRAM digunakan antara lain untuk menyimpan bobot model, aktivasi, tensor, dan cache.
Berapa kapasitas VRAM yang dibutuhkan untuk menjalankan AI?
Kebutuhan VRAM bergantung pada ukuran model, metode training atau inference, presisi numerik, panjang konteks, dan jumlah permintaan bersamaan. Karena itu, kapasitas ideal perlu ditentukan berdasarkan workload yang akan dijalankan.
Apakah semua AI membutuhkan GPU server?
Tidak. Beberapa workload Machine Learning dapat dijalankan menggunakan CPU, terutama jika model dan volume pemrosesannya relatif sederhana. GPU server lebih relevan ketika akselerasi komputasi memberikan manfaat yang sesuai dengan kebutuhan.
Apakah satu GPU cukup untuk menjalankan Large Language Model?
Satu GPU dapat menjalankan LLM apabila kapasitas memory dan kemampuan komputasinya mencukupi untuk konfigurasi model tersebut. Model yang lebih besar atau workload dengan kebutuhan lebih tinggi dapat memerlukan optimasi atau penggunaan beberapa GPU.
Apa perbedaan GPU untuk training dan inference?
Training menggunakan data untuk melatih atau memperbarui model AI, sedangkan inference menggunakan model yang sudah dilatih untuk menghasilkan output berdasarkan input baru. Keduanya dapat memiliki kebutuhan memory, throughput, dan konfigurasi GPU yang berbeda.
Apakah GPU server membutuhkan pendinginan khusus?
GPU server membutuhkan sistem pendinginan yang sesuai dengan konsumsi daya dan desain perangkat. Konfigurasi GPU dengan densitas tinggi mungkin memerlukan perencanaan aliran udara atau solusi pendinginan cair yang didukung oleh platform.
Apa saja yang harus diperhatikan sebelum membeli GPU server?
Pertimbangkan jenis workload, model GPU, kapasitas VRAM, CPU, RAM, storage, networking, konsumsi daya, pendinginan, kompatibilitas software, anggaran, dan kebutuhan ekspansi.
Apakah lebih baik membeli GPU server atau menggunakan Cloud GPU?
GPU server fisik dapat dipertimbangkan untuk workload yang berjalan secara konsisten dan membutuhkan kontrol langsung atas infrastruktur. Sementara itu, Cloud GPU dapat menjadi pilihan untuk kebutuhan komputasi yang fleksibel atau beban kerja yang berubah-ubah. Perbandingan keduanya perlu mempertimbangkan total biaya penggunaan, keamanan, ketersediaan sumber daya, dan kebutuhan operasional.
Diskusi Artikel
Punya pertanyaan atau pendapat tentang artikel ini? Silakan tinggalkan komentar.